Chmura obliczeniowa działa na rozproszonych sieciach serwerów. To jest prosta odpowiedź i to właśnie ten aspekt ma największe znaczenie, gdy ludzie pytają, czym naprawdę jest usługa chmurowa.
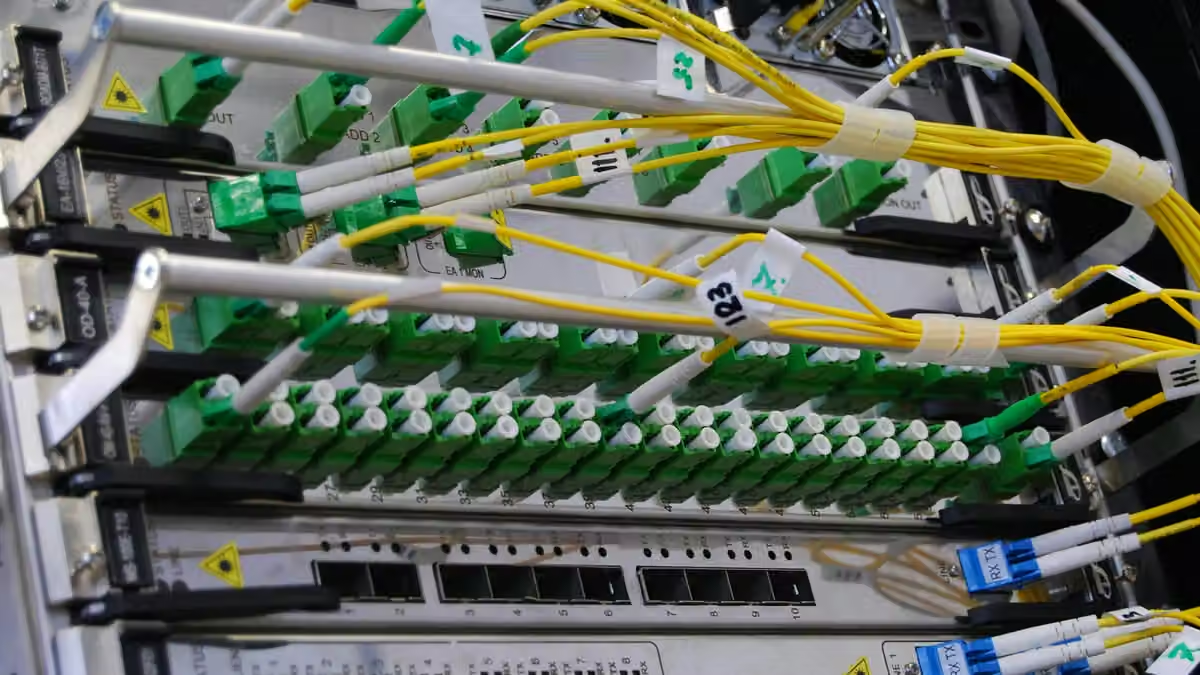
Wciąż wracam do jednego prostego punktu: chmura to nie jeden wielki komputer. To zbiór maszyn rozłożonych w szafach serwerowych, pomieszczeniach i centrach danych. Usługa ukrywa ten rozkład przed użytkownikiem. Użytkownik widzi jedno miejsce do przechowywania danych, uruchamiania kodu lub zapytania o bazę danych. Pod spodem wiele serwerów wykonuje pracę.
Dlatego systemy chmurowe są zbudowane wokół dystrybucji. Żądanie może trafić na jeden serwer, podczas gdy dane znajdują się na innym. Balanser obciążenia może kierować ruch na zdrowy węzeł, gdy przeciążony zwalnia. Dane mogą być kopiowane na kilka maszyn, aby usługa mogła działać dalej, jeśli jedna z nich ulegnie awarii. Z zewnątrz usługa wydaje się jednolita i płynna. Sprzęt wcale nie jest jednolity.
To również wyjaśnia, dlaczego usługi chmurowe skalują się tak dobrze. Jeśli popyt rośnie, dostawca może dodać więcej serwerów i rozłożyć pracę. Jeśli popyt spada, pojemność może ponownie się zmniejszyć. Najważniejszą ideą nie jest magiczna elastyczność. To koordynowany podział zasobów między pulę maszyn. To pula sprawia, że usługa jest elastyczna.
Usługa chmurowa zależy też od warstw. Istnieje sprzęt fizyczny w centrach danych. Istnieje łączność sieciowa między serwerami. Istnieje oprogramowanie, które przydziela zadania, przemieszcza dane i monitoruje awarie. Wirtualne maszyny i kontenery działają nad tym stosem i ułatwiają korzystanie ze sprzętu. Nie usuwają one systemu rozproszonego. Ułatwiają nim zarządzanie.
Ten punkt ma znaczenie, ponieważ chmurę obliczeniową często objaśnia się, jakby była tylko zdalnym dostępem. Zdalny dostęp istnieje, ale nie stanowi on podstawowej architektury. Podstawową architekturą jest rozproszona kontrola. Obliczenia, pamięć masowa i sieć są podzielone między wiele serwerów, a następnie połączone oprogramowaniem. To podział pozwala dostawcom chmury oferować tę samą usługę wielu użytkownikom jednocześnie.
Myślę, że ludzie czasem przeoczają tu kompromis. Rozproszone sieci serwerowe zapewniają zasięg, skalowalność i odporność na awarie. Przynoszą też więcej elementów, które mogą się psuć. Awaria może wystąpić w sieci, w magazynie danych, w płaszczyźnie sterowania lub w oprogramowaniu, które kieruje zadania. Dlatego usługi chmurowe nie są proste tylko dlatego, że łatwo z nich korzystać. Są to złożone systemy owinięte prostym interfejsem.
Jest jedna szczera granica warta powiedzenia na głos. Chmura nie ma jednego, stałego kształtu. Niektóre usługi są mocno rozproszone między regionami. Inne są bardziej scentralizowane w kilku centrach danych. Architektury brzegowe (edge) przenoszą obliczenia bliżej użytkowników. Architektury hybrydowe i wielochmurowe rozpraszają części systemu jeszcze bardziej. Dokładny układ zmienia się więc od usługi do usługi. Wspólna idea pozostaje ta sama: praca działa na sieci serwerów, a nie na jednym samotnym komputerze w kącie.
To jest praktyczna odpowiedź na pytanie „czym jest usługa chmurowa”. To usługa zbudowana na rozproszonych sieciach serwerów, ukryta za prostym interfejsem. Użytkownik otrzymuje współdzielone zasoby obliczeniowe, pamięć masową i sieć na żądanie. Dostawca otrzymuje system, który może rosnąć, przenosić zadania i regenerować się po awariach. Trudnym elementem nie jest fakt istnienia chmury. Trudnym elementem jest utrzymanie tego, by sieć masin zachowywała się jak jedna usługa.
O taką ideę stara się The Model Log: jeden praktyczny koncept sztucznej inteligencji, jeden działający przykład i jeden szczery взгляд na to, co naprawdę działa.